SatNOGS CSVからJPG画像を再構成するためのRubyツール on Linux #2

[目標]
1. 第一段階:候補データを抽出する
欠落している部分に対応しそうなデータを探す
複数の候補を拾い出す (前回,numb1200.htm)
2. 第二段階:候補を整理・評価する
各候補の位置、長さ、前後のデータとのつながりなどを確認
「この候補は有力」 「これは可能性が低い」 などの評価を行う (今回)
3. 第三段階:どの候補を採用するか自動判定する
評価結果を比較して最終的に復元データとして採用する候補
を決定し、最終的なJPGデータを作る (未作)
---------------------------------------------------------------------
[第二段階] 欠落Sequenceを SatNOGS 元CSVから自動検索する [search_missing.rb]
extract72.txt, extract_missing.rb, search_missing.rb, search_missing.rb
この三つのファイルを同じフォルダに置く。 search_missing.rb を実行すると、
61007mar.csv から missing_sequence.txt に記載された欠落sequenceを検索し、
PC_Terminal上に表示し、search_missing_result.txtファイルとして保存する。
$ ruby search_missing.rb と実行する。
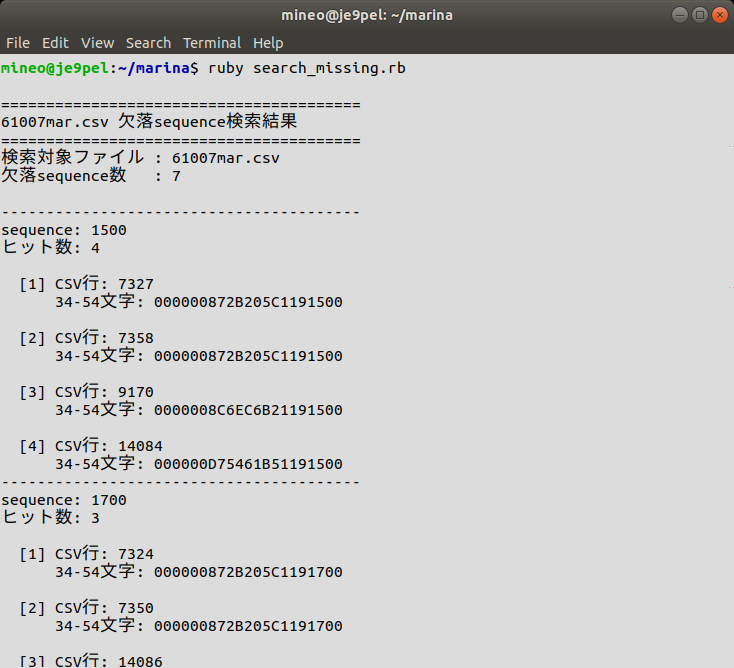 今回は、extract_missing.rb と search_missing.rb の実行で、SatNOGSの元CSV
から検索した欠落Sequence数が数個だったので、第三段階を試作する前にそれを
extract72.txt に補完して、extract73.txt と手動で保存した。欠落候補を選定
するには、extract72.txt にできるだけ近い時刻のものを選定することである。
日時が離れると別の画像データを選定してしまうことがある。これが第三段階を
作る時の選定基準として最優先だと思う。
その後は、https://www.asahi-net.or.jp/~ei7m-wkt/numb1191.htm#revision に
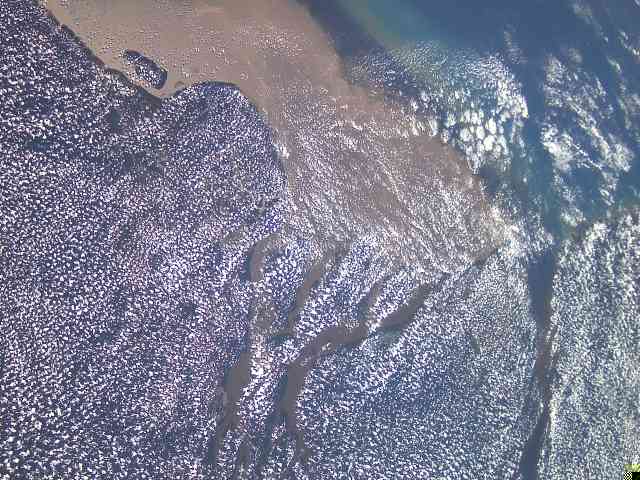
従い、one_line75.txt まで進んで手動でJPG画像化ができた。ほとんど真っ黒の
画像であったが、最上部に地球の一部が細く見えた。今度また、SatNOGS に良質
のデータがアップされた時に、次の第三段階(未作)の自動化を試してみたい。
[Marina_JPG 半自動化手順整理]
1. satnogs.csv: SatNOGSサイトからCSVファイル(week or month)をダウンロードして短く改名。
2. extract81.rb: "2026-08-08 23:","2026-08-08 22:","2026-08-08 21:" を含む行を抜粋保存。
3. extract82.txt: Sequence番号の 0000 と 0080 のデータ行には欠損があるので手動補完する。
4. extract83.rb: 各行を検索して、Sequence番号の規則性を維持して(+80h)、順に並べ替える。
5. extract_missing.rb: extract82.txtに実在しない番号を検索し、missing_sequence.txtに出力する。
6. search_missing.rb: satnogs.csvから欠落sequenceを探し、search_missing_result.txtに出力する。
7. extract83.txt: 欠落sequenceデータ行を補完して、extract83.txtとして手動上書き保存する。
8. extract84.rb: 各行の最初と最後の不要部分をカットし、全行の主要データ範囲を抽出する。
9. one_line85.txt: extract84.txtの FFD8~FFD9 を一行に編集し、最後にJPG画像化して完成。
https://www.asahi-net.or.jp/~ei7m-wkt/numb1191.htm#revision
https://www.asahi-net.or.jp/~ei7m-wkt/numb1200.htm
https://www.asahi-net.or.jp/~ei7m-wkt/marirubz.htm
[JPG半自動化手順 Update]
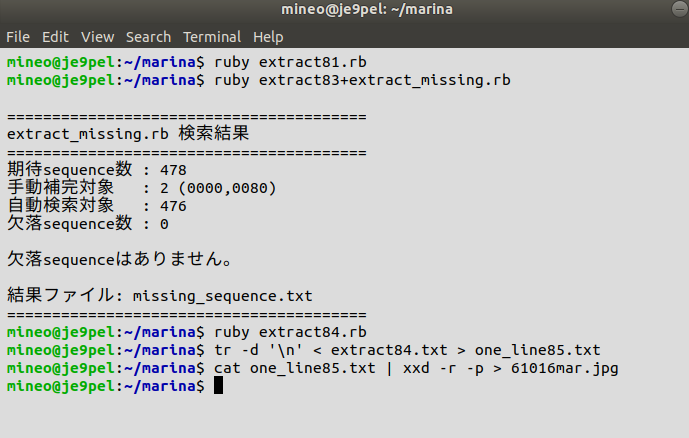
「4.extract83.rb」 と、「5.extract_missing.rb」 のRubyファイルを合体して、一つのRubyファイル:
「extract83+extract_missing.rb」 を作成した。
$ ruby extract83+extract_missing.rb と実行する。
入力ファイルは、extract82.txt の一つ。(rbファイル内で適宜書き換え可能)
出力ファイルは、extract83.txt と missing_sequence.txt の二つ。(同上)
 [第三段階] 選定基準(未作)
- 元CSVデータから、時刻差が小さい候補を優先して選定し保管する
- HEXデータの一致度と Sequence の整合性を確認する
- 条件を満たした候補だけを自動選定する
- 判定に迷うものは REVIEW として残す
 Back to Top
 Back to Revision